我们为什么把分流做到应用级
最初的产品假设是「按域名分流就够了」。上线后收到的反馈推翻了它:同一个浏览器里,有人希望某些页面走加速、某些保持本地;同一个域名下,桌面客户端与网页端的诉求相反。域名这一层的表达能力不够,必须下沉到应用层。
于是有了进程指纹识别:用路径、签名主体与文件哈希确认「这是哪个应用」,再用域名确认「它连的是什么服务」。两级结合之后,用户可以按应用授权,不必理解域名结构。
团队构成与分工
团队按职责分为四组:网络栈组负责协议与隧道实现,规则组负责分类与规则库维护,客户端组负责各平台应用与系统集成,支持组负责工单与问题归因。
- 网络栈组:私有协议、拥塞控制、切换与回退逻辑
- 规则组:域名与地址段分类、规则验证与回滚
- 客户端组:系统集成、网络层组件、诊断面板
- 支持组:工单分级、日志归因、规则反馈闭环
四个组共用同一套指标口径,避免「客户端说没问题、网络说也没问题,用户还是慢」这类扯皮。
如何核对本站说明与实际版本是否一致
判断一篇技术说明是否可信,最直接的方法是把它和客户端里的实际字段对上。下面四步可以在两分钟内完成核对。
- 核对版本号:客户端「关于」中显示的版本应与本站说明的版本线一致,例如 v5.1 对应三级识别引擎。
- 核对规则库编号:规则库独立编号,可在设置中查看,与本站提到的更新节奏对应。
- 核对字段名:诊断面板中的「判定依据」「通道」「首包时间」「重试次数」四列名称应与本站说明一致。
- 核对边界描述:本站写明「不做 TLS 解密」「不做内容留存」,你无法在客户端中找到任何明文审计入口,这就是边界的体现。
说明口径与可核对项对照
| 本站表述 | 在客户端中的对应位置 | 不一致时 |
|---|---|---|
| 三级识别引擎 | 诊断面板「判定依据」列的三类取值 | 以客户端为准并提交文档反馈 |
| 规则库每周更新 | 设置中的规则库版本与更新时间 | 检查更新通道是否被拦截 |
| 不做内容留存 | 诊断面板仅有连接元信息,无内容字段 | 立即通过安全渠道报告 |
| 不共享账号 | 新设备登录会自动挤下旧设备 | 检查设备管理中的登录记录 |
为什么有些数字写了口径却不给绝对值?
因为节点距离与链路质量差异很大,给统一承诺反而误导。我们给的是分档参考值与测量口径,便于你自行复现。
你们会不会随时改说明?
涉及行为变化的说明会随版本发布同步更新,并在新闻中心记录变更要点,不会静默修改。
发现文档和客户端不一致怎么办?
以客户端为准,并通过工单反馈具体页面与字段,我们会核查后修正。
技术路线选择与放弃的方案
选择私有协议 + 终端分流这条路线,是权衡后的结果。走过的弯路同样值得写下来。
| 方案 | 结论 | 原因 |
|---|---|---|
| 全局代理(不分类) | 放弃 | 本地访问被拖慢,用户体感差 |
| 仅按域名分流 | 升级 | 无法区分同一域名下的不同应用 |
| 仅按地址段分流 | 放弃 | CDN 场景误判率高 |
| 套用通用代理协议 | 放弃 | 报文特征明显,受限网络下可用性差 |
| 私有协议 + 三级识别 | 采用 | 精度与可用性兼顾,代价是维护成本更高 |
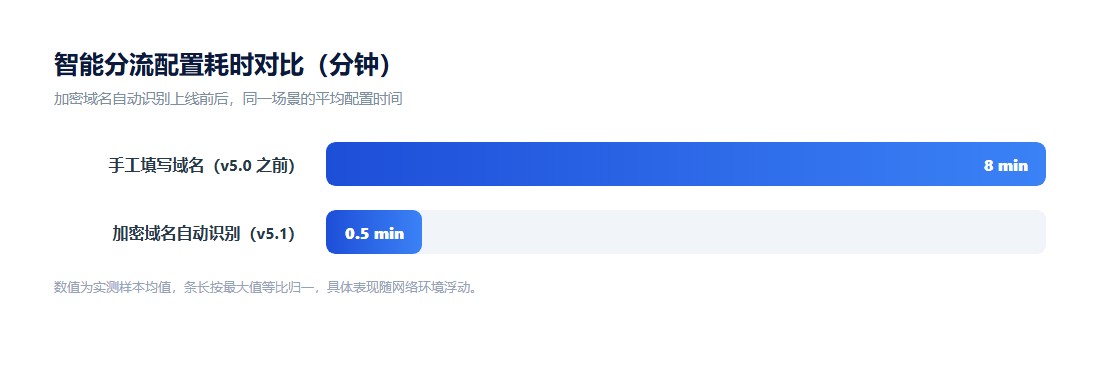 配置耗时对比:手工填写与自动识别
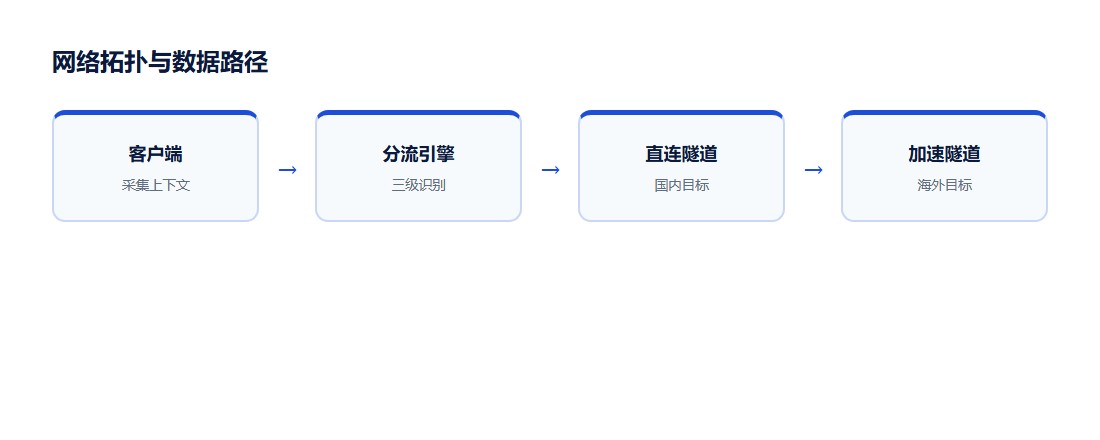 网络拓扑:终端判定 + 双通道出口
工程原则
四条原则贯穿所有版本,它们决定了遇到取舍时怎么选。
- 默认安全:默认配置应当是安全的,危险选项必须显式开启并解释后果。
- 可解释:任何自动判断都要能在诊断面板里看到依据,不接受黑箱。
- 可回滚:客户端与规则库都保留上一版,出问题先回滚再排查。
- 最小采集:只采集判定必需的信息,不采集访问内容。
明确不做的四件事
说清不做什么,比宣传做什么更能建立信任。
- 不做 TLS 解密:不持有用户证书私钥,不提供明文审计
- 不做流量内容留存:不记录访问内容,诊断记录只含连接元信息
- 不做账号共享:一个席位同一时间只服务一台设备
- 不做未授权的网络改造:不在企业网络中擅自部署覆盖性组件
这四条是产品边界,不是阶段性限制。需要明文审计或内容留存的场景,应改用企业级网关方案。
版本迭代节奏
客户端与规则库分开迭代:客户端按月度节奏发布功能版本,规则库按周更新。两者分开是为了让「分类变化」与「程序变化」互不牵连,出问题时能快速定位在哪一侧。
| 类型 | 节奏 | 是否需重启 | 可回滚 |
|---|---|---|---|
| 规则库 | 每周一次常规,紧急 24 小时内 | 否 | 是 |
| 客户端功能版 | 月度 | 是 | 保留上一版安装包 |
| 紧急修复版 | 按需 | 是 | 是 |
质量与测试标准
分流产品的质量不能只看「能不能连上」,还要看「判断对不对」。测试分三层。
- 判定准确率:对样本集合统计分类正确率,重点看误判为加速的比例
- 切换成功率:模拟节点劣化,统计切换后连接恢复的比例与耗时
- 回归覆盖:每次规则库发布前对固定样本集跑一遍,比较与上一版的差异
三层都通过才允许发布。规则库的回归结果会作为发布说明的一部分,标注本次分类变化的影响范围。
责任边界与合规态度
产品只解决网络路径与质量问题,不改变用户访问内容的合法性与合规责任。用户需自行遵守所在地法律法规与服务条款;客户端不提供绕过合规审计的能力。
在合规上采取三条做法:不做内容留存、不做明文审计、不提供固定出口的规避方案;同时在协议层保护隧道内数据的机密性与完整性。
常见质疑的回应
你们会不会看到我访问了什么?
不做内容留存,也不做 TLS 解密。诊断记录只包含判定依据、通道与耗时这类元信息,默认 7 天后清理。
为什么不做明文审计功能?
这是产品边界。需要明文审计的场景应使用企业级网关,终端方案不适合承担这个职责。
规则库会不会把我的自定义规则覆盖掉?
不会。用户规则优先级高于库规则,库更新不会覆盖用户配置。
为什么有些平台做不到进程级分流?
受系统权限限制。移动端无法读取其他应用的可执行文件信息,因此改为按应用标识分流,能力边界如实说明。
更新与公告的发布方式
所有变更都会先发布说明再推送:客户端功能版本在新闻中心公告,规则库更新在客户端内提示变更条目数。
涉及需要用户操作的变更(例如需要重新登录或需要重启系统),会单独标注并给出最短操作路径,不会把「需要重启」藏在长长的更新日志里。
反馈与改进闭环
分流问题的价值很高:每一次误判都对应一条可修复的规则。因此支持流程被设计成闭环。
- 提交:用户提交诊断日志包与现象描述。
- 归因:支持组判断是规则问题、节点问题还是本地环境问题。
- 修复:规则问题进入规则库更新,节点问题进入节点治理,环境问题给出配置建议。
- 回告:修复完成后回复提交者,并在更新说明中标注该类问题的处理情况。
关于本站
本站是快连的官网站点,用于说明产品能力、技术原理与配置方法,并提供客户端下载与支持入口。
站内内容围绕「进程指纹识别与加密域名自动分流」这一主题组织,页面中的数值均标注了口径与适用条件;若你对某个数字的测量方式有疑问,可通过服务支持渠道反馈,我们会补充口径说明。
配置耗时对比:手工填写与自动识别网络拓扑:终端判定 + 双通道出口